提取到文字,只完成了第一步
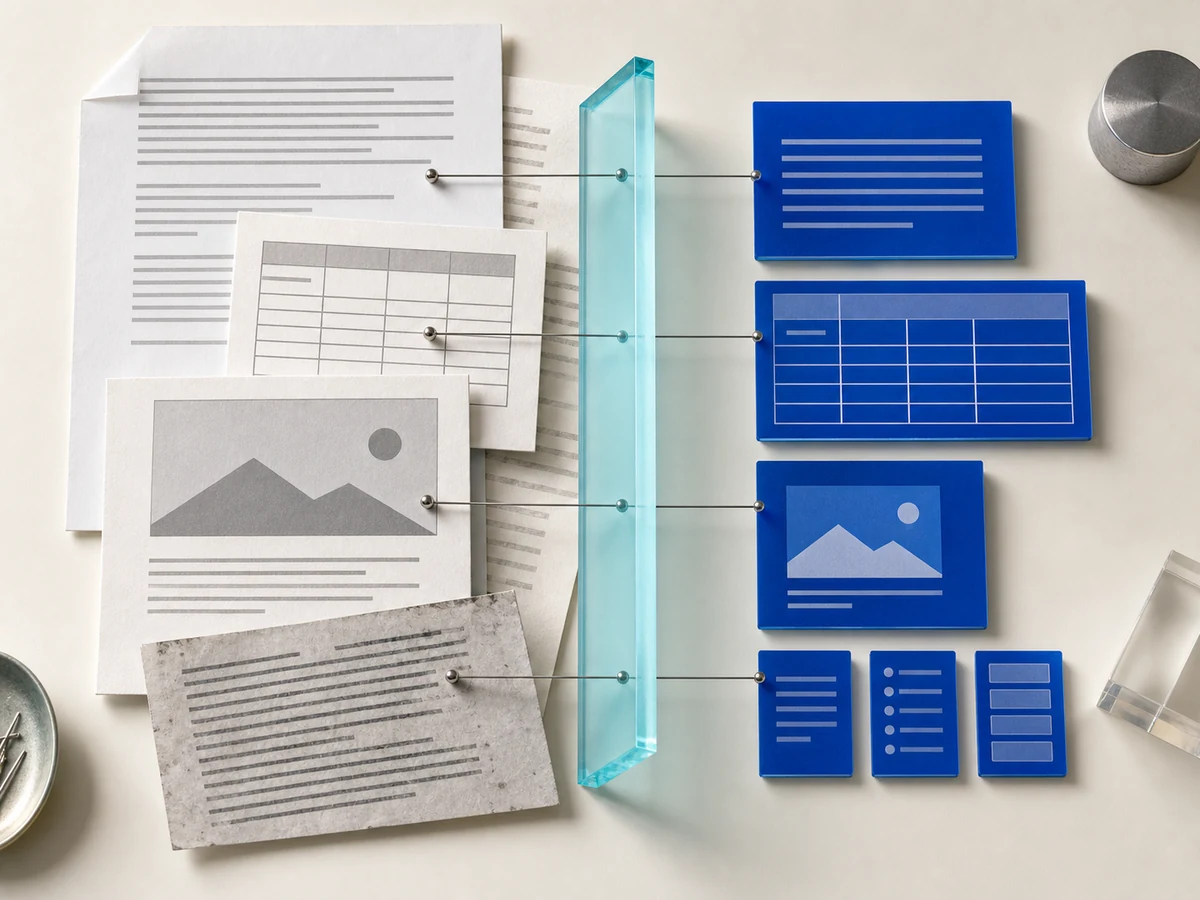
一份 PDF 可能是可复制文本,也可能是扫描图片;同一页里还有页眉、脚注、双栏、表格和印章。传统 OCR 能把字符读出来,却未必知道某个数字属于哪一列、某段说明对应哪张图。业务真正需要的通常不是一串文本,而是带结构和出处的数据。
文档解析项目应先定义下游任务。若目标是全文检索,需要保留标题层级与段落;若要处理询价单,重点是物料、规格、数量和交期;药化论文则要关联正文、结构图、实验表和补充材料。任务不同,解析字段和复核方式也不同。
入口先做文件识别与质量检查
系统收到文件后,可以先判断格式、页数、是否加密、是否有文本层,以及图片清晰度和方向。低分辨率、严重倾斜、裁边或压缩失真的扫描件,应直接标记质量问题,不能让后面的模型把模糊字符猜成确定字段。
文件分流也能节省成本。结构稳定的电子表格可以直接读取单元格,不必先转图片;可复制 PDF 优先提取文本和坐标;扫描件再进入 OCR 与版面分析。对复杂文件使用更强模型,对简单文件走轻量路径,整体更可控。
版面、表格和字段要分别处理
版面分析负责识别标题、段落、列表、表格和图片区块,并保存阅读顺序。表格解析还要处理合并单元格、跨页表头和单位。字段抽取则根据业务定义,把“交付日期”“希望到货时间”等不同叫法归到同一字段。
这些步骤不能只留下最终值。每个字段应能回到页码和区域,保留原始文本与规范化结果。例如系统把“1,500 kg”转成数值和单位时,复核人员仍能看到原文,避免逗号、小数点或单位换算造成隐蔽错误。
图片里的信息需要单独定义证据
产品照片、化学结构图、流程图和仪器截图不能简单当作装饰。项目要先确定图片中哪些内容需要识别,哪些只能提供人工查看。若模型描述图像,应把描述与原图位置绑定,并标明这是识别结果,不是文档作者的原话。
图文关系也很重要。论文里的图注、图号与正文引用需要连接;询价资料中的照片可能对应上一行物料,也可能是一组附件。系统无法确认关系时应保留候选,不应为了生成完整结构而强行配对。
人工复核应围绕不确定项展开
让人逐页重看整份文件,等于没有真正减少工作。解析结果可以把低置信字符、字段冲突、缺失必填项和异常单位集中到复核界面。复核人员看到原文片段、系统结果与业务规则,确认后再进入下一步。
抽样复核适合高频、格式稳定的资料;金额、配方、安全和正式报价等字段则可能需要逐项确认。风险等级应由业务决定,不能只用模型置信度代替。模型很自信,也可能读错一张模糊表格。
解析结果进入流程前,还要通过业务校验
结构化数据写入 CRM、报价系统或科研知识库前,需要检查必填字段、类型、范围、重复记录和权限。原始文件、解析版本和人工修改应关联保存,后续模型升级时才能重跑并比较差异。
验收样本要覆盖真实文件分布,包括好文件和坏文件。团队可以分别统计文件成功率、字段准确情况、人工复核时间和无法处理的原因。只报一个总准确率,会掩盖某类关键文档长期失败的问题。