模型榜单回答不了企业自己的问题
模型在数学、代码或通识基准上的分数,有助于了解能力范围。企业真正关心的却是另一组问题:它能不能读懂本公司的文档,是否会引用旧制度,能否按接口格式输出,遇到缺失信息会不会停下。公开榜单很少覆盖这些细节。
NIST 2026 年发布的语言模型自动化基准评测实践草案提出,评测首先要定义目标,再选择适合目标的基准。对企业项目来说,这意味着先写清使用场景和决策,再决定测什么,不能先拿到一个模型分数再解释它有什么用。
样本从真实任务中来,也要保护真实数据
可以从历史工单、咨询、文档和流程记录里挑出有代表性的任务,去除不必要的个人信息和商业敏感字段。样本应覆盖常见情况,也保留少量边界与失败案例,例如错别字、缺附件、权限不足和相互冲突的资料。
数量不必一开始就很大。几十到几百个经过业务人员确认的样本,通常比上千个自动合成问题更能暴露问题。后续把线上失败加入评测集,样本库会随着产品使用逐步变得有价值。
每个样本都要说明什么算合格
有些任务有唯一答案,例如提取订单号;有些任务需要检查要点,例如客服回复是否引用当前政策、有没有做未授权承诺。评测条目应记录必须包含、不得出现、是否需要来源和何时必须转人工。
严重错误要单独标记。泄露其他客户数据、把训练建议当招聘结论、修改未经授权的业务状态,即使只发生一次,也不能被平均分掩盖。上线门槛应同时包含总体表现和零容忍项。
把链路拆开,才知道该改哪里
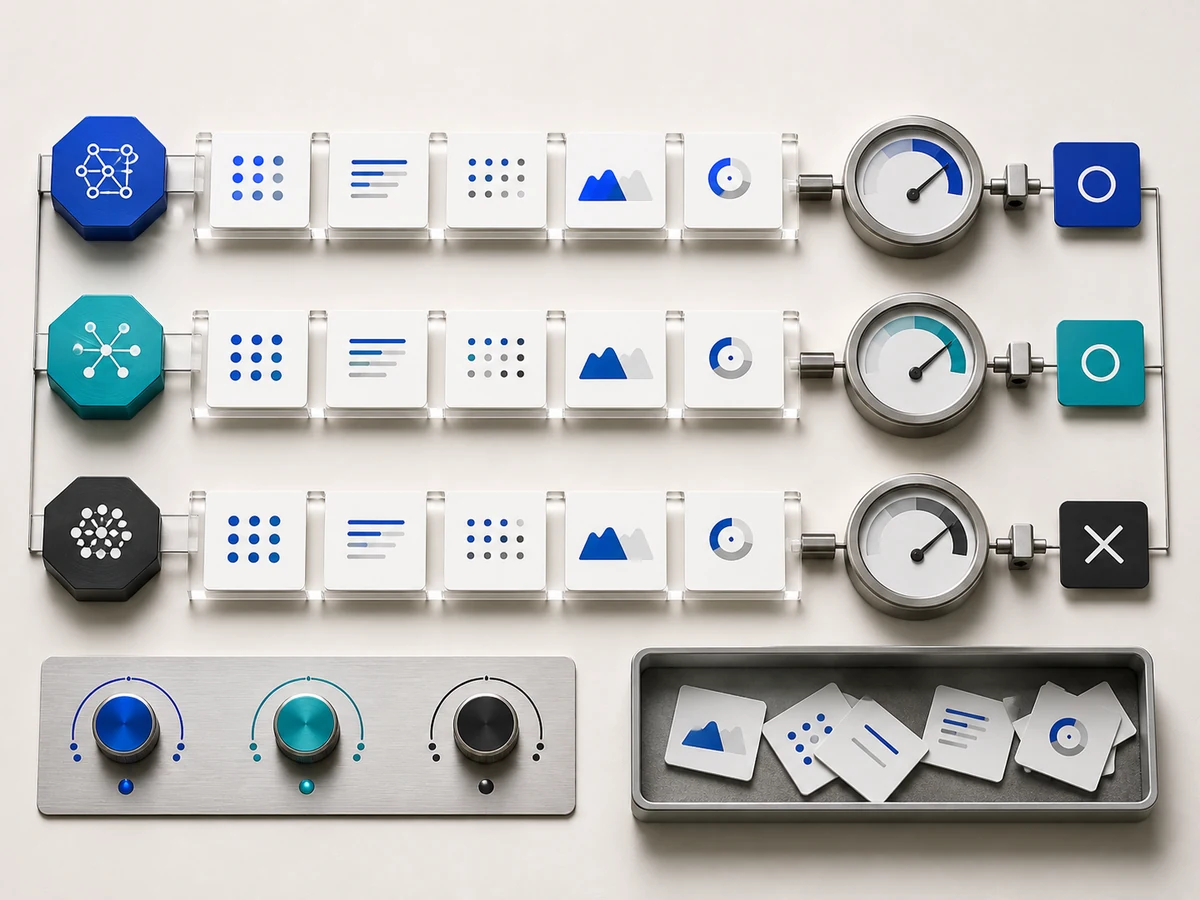
知识问答至少分成检索与生成。先看正确资料是否进入候选,再看回答是否忠实使用。Agent 还要检查工具选择、参数、权限和最终状态。只给整段输出打一个分,团队很难判断应该换模型、调检索还是修接口。
自动评分适合格式、关键词和部分一致性检查,主观或高风险任务仍需要人工抽检。评分模型本身也可能偏好某种写法,因此要用一部分人工确认结果校准,并定期复查分歧。
模型选择需要同时看质量、速度和成本
更大的模型不一定适合每一步。资料分类和字段整理可以使用速度更快的模型,复杂推理再切换到能力更强的模型。评测时记录输入输出量、响应时间、失败率和重试情况,才能估算真实运行成本。
还要在不同时间重复运行。模型服务、提示和知识更新都可能改变结果。单次测试很高,不代表线上长期稳定。重要流程可以固定模型版本,并在切换前完成回归。
评测集是一项持续维护的产品资产
每次线上失败都值得问一句:这个问题能否转成一个以后必测的样本。业务人员补充期望结果,技术团队记录修复版本。时间久了,评测集会包含企业最容易踩坑的地方。
评测报告也应面向决策。它需要说明哪些任务已经达到上线条件、哪些必须人工复核、剩余风险是什么,而不是只罗列模型分数。这样更换模型或增加功能时,团队有一条稳定的比较基线。
评测集本身也需要版本。新增样本时记录它来自哪类业务失败、为什么重要、预期结果由谁确认;淘汰样本时说明原因。不同版本之间保留一组长期不变的核心题,才能判断进步来自模型与系统,还是来自题目变得更容易。核心题对应的业务事实发生变化时,先更新依据,再保留旧版结果供追溯。