文献筛选的目标,是更快回到值得读的原文
研发团队围绕一个靶点、化合物系列或实验方法检索时,结果可能包含大量论文和补充材料。系统可以解析标题、章节、图表、参考文献与关键词,按研究问题形成候选清单,并说明为什么命中。
候选清单不是研究结论。题录、文献版本、来源链接和命中位置要保留,研究人员可以快速排除不相关资料。摘要里没有出现的信息,不应根据标题或相似论文自动补全。
正文、结构图和补充材料要一起解析
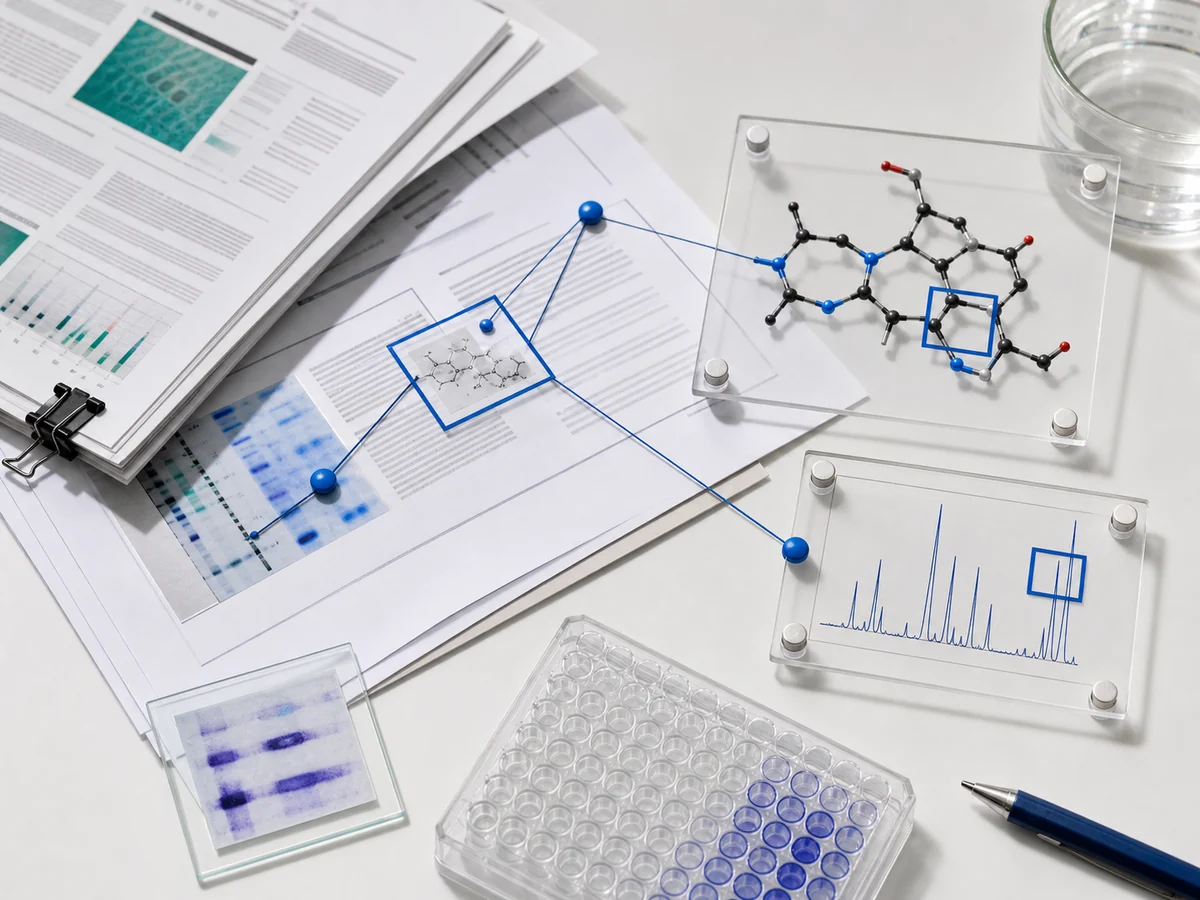
药化关键信息常常分散在正文、表格、结构图、图注和补充文件中。只提取正文文本,会漏掉化合物编号与结构关系;只识别图像,又可能失去实验方法和单位说明。解析需要保留不同内容之间的关联。
系统可以识别章节和版面,再对化合物编号、分子结构、实验条件、检测方法和活性描述做字段抽取。每个结果关联页码、表号或图像区域,复核人员能看到模型读到的原始内容。
字段统一不能抹掉实验口径差异
不同论文对化合物、单位和活性指标的写法不同。系统可以统一字段名、拆分数值与单位,并提示可能的同义表达。但原始值和规范化过程都要保留,特别是范围、约等于、低于检测限等表达。
图像识别、化学命名和单位换算都可能出错。关键字段设置人工校对,缺失项明确标记为空。为了让表格完整而推测数值,会把不可见的错误带进后续比较。
跨文献比较先检查能不能比
团队比较多个化合物系列时,AI 可以按共同字段整理实验条件、活性数据和证据出处,减少机械查找。比较前还要检查检测方法、样本、批次、单位和评价指标是否一致。
不可直接比较的数据可以并列展示并说明差异,不能强行合成统一排名。模型适合提示“这两项口径不同”,研究人员再决定是否需要换算、补实验或放弃比较。
复核过的资料才能进入科研知识库
研究人员确认后的文献条目、分子字段和笔记可以按项目、靶点、骨架与权限保存。自然语言检索帮助团队找回资料,回答同时展示原始出处和最后复核时间。未确认的自动抽取结果放在单独状态。
文献更新、勘误和内部研究进展都可能改变条目。知识库要记录版本与修改人,不覆盖旧记录。项目成员变更后,访问权限随组织与项目及时调整。
用金标准样本验收解析链路
首轮选择一组研究人员熟悉的论文,覆盖正文、表格、结构图和补充材料。专业人员标注需要的字段与原文位置,分别评测文档解析、字段抽取、关系关联和检索,不用一个总分掩盖具体失败。
系统上线后,把误识别、漏检和不可比数据加入回归样本。FDA 与 EMA 对医药研发 AI 的近期原则都重视明确用途、数据治理、性能评估和生命周期管理。论文解析虽然属于辅助任务,也应把这条可信链保留下来。
验收样本还要记录阅读它需要的专业背景。结构识别由药化研究人员复核,实验方法与活性口径交给熟悉该领域的人判断,文档工程人员则检查页码、版面和附件关系。不同角色分别签认,能避免把版面识别正确误当成科研含义正确。无法判断的结构或条件保持待复核状态,不以相似文献替代当前证据。团队还能据此识别系统暂时不适合处理的文献类型。相关边界应在文章和系统界面里同时说明。